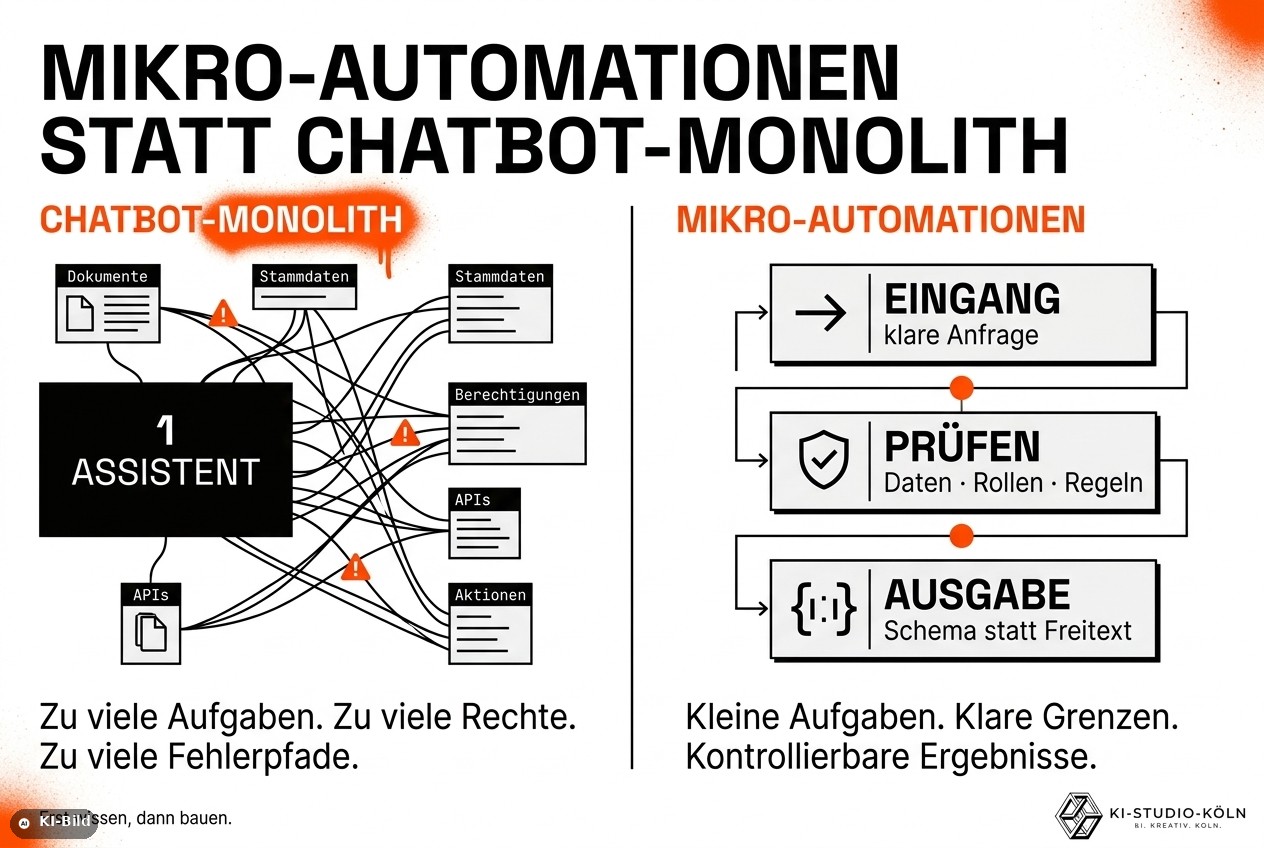
Ich halte den zentralen KI-Chatbot in vielen Mittelstandsprojekten für die falsche erste Investition. Nicht weil Sprachmodelle ungeeignet wären, sondern weil ein einziger Assistent meist zu viele Aufgaben, Datenquellen und Rechte zugleich tragen soll.
Der Chatbot-Monolith verdeckt die eigentliche Entscheidung
Ich sehe oft dieselbe Ausgangslage: Eine überzeugende Demo, ein Angebot oder eine knappe Anforderung steht im Raum. Offen bleibt, welche Informationen das System konkret verarbeiten, welche fachlichen Regeln es beachten und welche Folgeaktionen es auslösen darf. Genau dort beginnt das Risiko.
Ein zentraler Chatbot soll häufig gleichzeitig Dokumente durchsuchen, Inhalte interpretieren, Entscheidungen vorbereiten und Aktionen in anderen Systemen ausführen. Damit landen unterschiedliche Fehlerklassen in einem Baustein. Eine falsche Quelle kann zu einer fachlich unzulässigen Antwort führen, eine fehlende Berechtigung zu Datenabfluss und ein Integrationsfehler zu einer unerwünschten Aktion.
Ich bewerte daher nicht zuerst die Chat-Oberfläche oder die Qualität einer Demo. Ich prüfe den Prozess dahinter. Wenn Eingang, erwartete Ausgabe, Datenquellen, Rollen und Ausnahmefälle nicht eindeutig sind, löst ein großer Assistent das Vorhaben nicht. Er verdeckt nur die offenen Entscheidungen.
Warum ein großer Assistent selten der belastbare Einstieg ist
Der Monolith wirkt attraktiv, weil er eine zentrale Anlaufstelle verspricht. Im Betrieb muss er jedoch sehr unterschiedliche Regeln gleichzeitig einhalten. Er braucht Zugriff auf Dokumentwissen, Stammdaten und gegebenenfalls Werkzeuge. Zugleich muss er erkennen, wann er informieren, einen Entwurf liefern oder eine Aktion auslösen darf.
Ich trenne diese Aufgaben, weil jede andere Kontrollen benötigt. Exakte Stammdaten bleiben im führenden Fachsystem. Retrieval ergänzt Dokumentwissen. Das Sprachmodell übernimmt Interpretation oder die Orchestrierung klar begrenzter Schritte. Es wird nicht zur unkontrollierten Quelle für verbindliche Fakten.
- Falsche Quellen: Dokumente können unvollständig, veraltet oder widersprüchlich sein. Ein Modell kann diese Konflikte nicht verlässlich auflösen, wenn Regeln und Quellenprioritäten fehlen.
- Ungültige Ausgaben: Freitext ist keine belastbare Schnittstelle. Strukturierte Ergebnisse müssen gegen ein definiertes Schema validiert werden.
- Fehlende Rechte: Datenzugriff kann für eine Rolle zulässig und für eine andere Rolle vertraulich sein. Eine gemeinsame Oberfläche hebt diese Trennung nicht auf.
- Integrationsfehler: Eine technisch erreichbare API ist noch keine fachlich erlaubte Aktion. Fehlerhafte Übergaben können Folgeprozesse auslösen.
- Unklare Verantwortung: Ohne manuellen Übergabepunkt bleibt offen, wer unsichere Ergebnisse prüft und wer bei Fehlern entscheidet.
Diese Risiken sprechen nicht gegen KI. Ich behandle sie als Architekturfragen. Sie müssen vor dem Prompt beantwortet werden, denn ein Prompt ersetzt weder Berechtigungen noch Rückfallwege oder Kostenkontrolle.
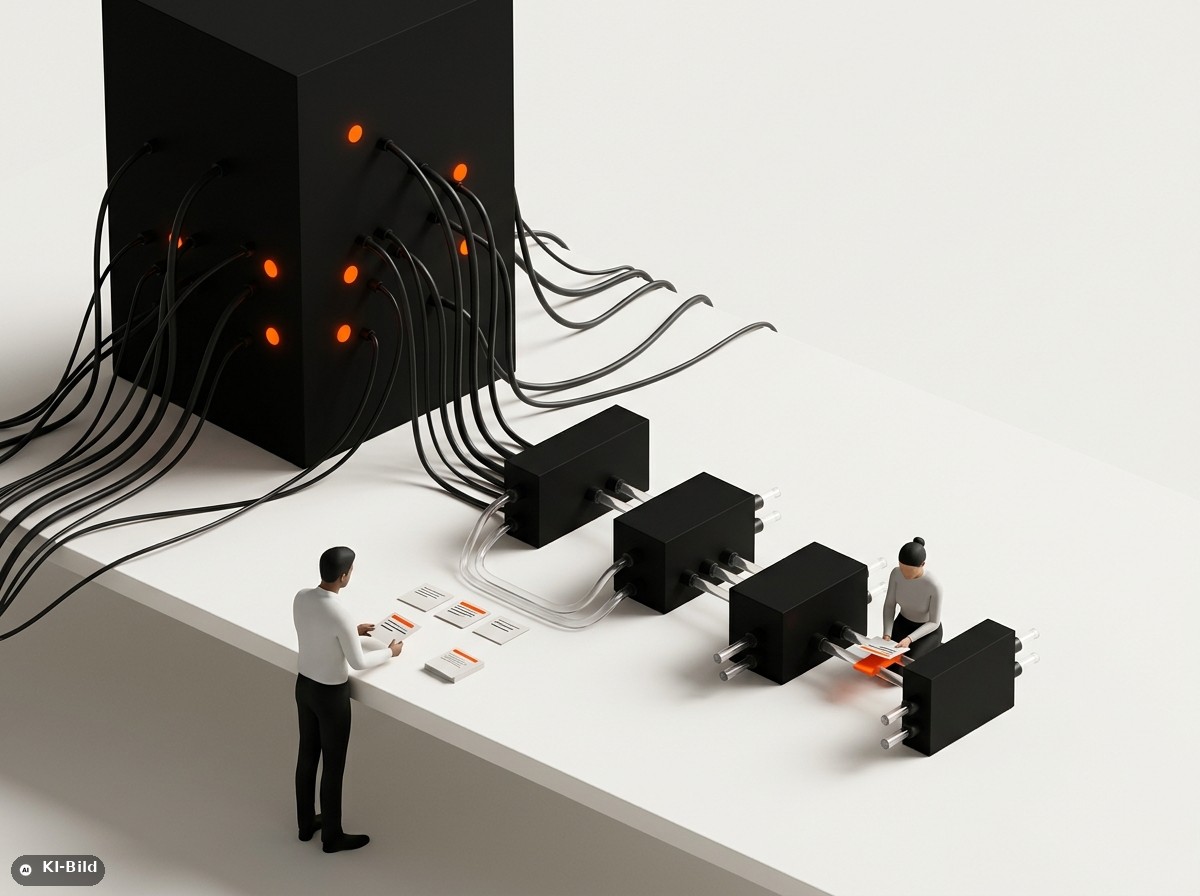
Was ich unter einer Mikro-Automation verstehe
Eine Mikro-Automation isoliert einen wiederkehrenden Arbeitsschritt. Sie hat einen klaren Startpunkt, einen definierten Eingang und eine erwartete Ausgabe. Die Aufgabe bleibt auf einen fachlich begrenzten Vorgang ausgerichtet, etwa auf das Zusammenstellen freigegebener Informationen in einem festgelegten Ausgabeformat.
Der Unterschied ist nicht kosmetisch. Bei einer Mikro-Automation lässt sich konkret prüfen, ob ein Ergebnis verwendbar ist, ob die Zuständigkeit stimmt und was bei Unsicherheit passiert. Das schafft eine andere Grundlage für Abnahme und Erweiterung.
Geeignete Aufgaben können sein:
- eingehende Informationen nach festgelegten Kriterien klassifizieren,
- definierte Felder aus freigegebenen Dokumenten extrahieren,
- E-Mails für die weitere Bearbeitung vorqualifizieren,
- Felder als Entwurf vorbefüllen,
- Tickets anhand klarer Regeln an die zuständige Stelle weiterleiten.
Eine Mikro-Automation ersetzt nicht automatisch ERP, DMS, CRM oder Ticketsystem. Diese Systeme bleiben die führenden Orte für Stammdaten, Vorgänge und fachliche Entscheidungen. Das Sprachmodell kann dazwischen arbeiten: Es interpretiert unstrukturierte Eingaben, bereitet einen strukturierten Vorschlag vor und übergibt ihn nur über definierte Schnittstellen weiter.
Vier Bausteine, die vor dem Prompt stehen müssen
Ich beginne nicht mit einem Prompt. Ich beginne mit den Bedingungen, unter denen ein Prozessschritt fachlich und technisch verantwortbar ist. Für eine Mikro-Automation dokumentiere ich mindestens diese vier Bausteine:
- Eingang: Welche Daten kommen hinein? Aus welchem System? Welche Informationen dürfen verarbeitet werden, und welche fehlen möglicherweise?
- Aufgabe und Ausgabe: Was soll der Baustein genau tun? In welchem strukturierten Format muss das Ergebnis vorliegen? Welche Felder, Datentypen und zulässigen Werte gelten?
- Eigentümer: Wer verantwortet den Prozess fachlich? Wer prüft unsichere Ergebnisse? Wer entscheidet über Änderungen an Regeln und Ausgabeschema?
- Fallback: Was passiert bei ungültigen Ausgaben, geringer Evidenz, technischen Fehlern oder fehlenden Berechtigungen? Der Rückfallweg muss ein echter Übergabepunkt sein, keine Fußnote.
Dieses Modell verhindert nicht jeden Fehler. Es sorgt aber dafür, dass Fehler sichtbar werden und in einen kontrollierten Ablauf führen. Genau das fehlt häufig, wenn ein Chatbot als universelle Lösung starten soll.
Akzeptanzkriterien statt allgemeiner Eindrücke
Ein Pilot ist nicht abgenommen, weil einzelne Antworten plausibel wirken. Ich definiere mit dem Fachbereich vorher, woran ein Prozessbaustein gemessen wird. Die Kriterien hängen vom konkreten Vorhaben ab.
Sie können beispielsweise festlegen, ob strukturierte Ausgaben gültig sind, wann eine manuelle Eskalation erforderlich ist, welcher Bearbeitungsaufwand entsteht oder welche Fehlklassifikationen akzeptabel beziehungsweise nicht akzeptabel sind. Ebenso können Durchlaufzeit, Infrastruktur- oder API-Kosten und Sicherheitsereignisse relevant sein.
Wichtig ist die Reihenfolge: Diese Größen werden im konkreten Projekt erhoben. Ich formuliere daraus kein allgemeines Versprechen über Zeitersparnis oder Fehlerreduktion. Erst eine dokumentierte Ausgangslage und reale Testfälle zeigen, ob der Baustein den gewünschten Effekt hat.
Nur einen Architekturzweck pro Pilot priorisieren
Viele Vorhaben werden unnötig schwer, weil ein Pilot gleichzeitig Wissen durchsuchen, Daten verändern und Entscheidungen automatisieren soll. Ich trenne daher die erste Fragestellung.
- Automatisierung: Ein klarer Schritt wird vorbereitet oder ausgeführt, mit enger Eingrenzung der erlaubten Aktionen.
- Retrieval: Das System findet und verdichtet freigegebene Informationen, ohne Daten zu verändern.
- Absicherung: Berechtigungen, Validierung, Logging, Freigaben und Rückfallwege werden so gestaltet, dass der spätere Betrieb kontrollierbar bleibt.
Diese Zwecke können später zusammenkommen. Im ersten Pilot sollten sie nicht miteinander konkurrieren. Sonst ist am Ende nicht erkennbar, ob das Problem an Datenqualität, Berechtigungen, Modellverhalten, Integration oder Prozesslogik liegt.
Wie ich einen risikoärmeren Einstieg prüfe
Für den Einstieg wähle ich einen wiederkehrenden Vorgang mit überschaubarem Risiko und eindeutigem Eigentümer. Ein Schritt mit echten Beispieldaten ist wertvoller als eine breite Vision ohne überprüfbare Grundlage.
Der Ablauf sieht dann so aus:
- Ausgangsprozess, Datenquellen, Rollen und Ausnahmefälle erfassen.
- Ein Ausgabeformat definieren und die Ergebnisse dagegen validieren.
- Mit echten, freigegebenen Beispielen testen, statt nur mit idealisierten Demo-Eingaben.
- Unsicherheit und technische Fehler als manuelle Übergabepunkte modellieren.
- Integration, Logging, Kostenannahmen und Rückfallweg prüfen.
- Erst nach nachvollziehbarer Abnahme den nächsten Prozessschritt ergänzen.
Je nach Risiko kann der erste Schritt auch rein lesend sein: Das System sucht, analysiert oder fasst zusammen, ohne Daten zu verändern. Danach kann es Entwürfe erzeugen, die ein Mensch freigibt. Erst wenn Daten, Rollen, Qualität und Rückfalloptionen belastbar sind, sollte eine begrenzte Aktion geprüft werden.
Vom unklaren Vorhaben zur belastbaren Entscheidung
Genau dafür ist mein KI-Machbarkeits-Audit gedacht. Es richtet sich an Unternehmen, die ein konkretes KI-Vorhaben vor sich haben, aber Datenmodell, Rollen, Kostenannahmen, Integrationen und Ausstiegsszenarien noch nicht sauber beurteilen können.
Im Audit kläre ich Anforderungen, geeignete Technologie, Datenmodell und API-Kostenannahmen. Daraus entsteht ein Architekturbericht mit Umsetzungsfahrplan. Der Bericht wird als Markdown und PDF übergeben und gehört dir. Dazu gehört ausdrücklich auch die Option, ein Vorhaben nicht zu bauen, wenn Aufwand, Risiko oder Datenlage keine tragfähige Grundlage ergeben.
Der Festpreis liegt bei 1.500 €; der Endbetrag wird ohne Umsatzsteuer nach § 19 UStG ausgewiesen. Entscheidend ist nicht der Bericht als Dokument, sondern die Entscheidung, die danach möglich wird: einen klar abgegrenzten Baustein kontrolliert bauen, Voraussetzungen schließen oder den Ansatz begründet stoppen.
Fazit
Ein großer Chatbot kann später sinnvoll sein. Als erster Schritt ist er oft zu breit, um Daten, Rechte, Kosten, Fehlerpfade und fachliche Verantwortung sauber zu prüfen.
Eine Mikro-Automation macht diese Fragen konkret. Sie zwingt zu einem klaren Eingang, einer begrenzten Aufgabe, einer prüfbaren Ausgabe und einem echten Fallback. Das ist weniger spektakulär als ein universeller Assistent. Für einen belastbaren Start ist es meist die bessere Architekturentscheidung.
Wenn du dein konkretes Vorhaben vor dem nächsten Build strukturiert prüfen willst, findest du im Audit-PDF die Grundlage und den Ablauf des KI-Machbarkeits-Audits. ki-studio.koeln/leistungen